


Ejecutar un LLM localmente en una Raspberry Pi 5 suena muy bien en un titular, y es una experiencia bastante distinta una vez que de verdad la mides. Esto es lo que medimos tras unas semanas corriendo modelos cuantizados en una Pi 5 de 8GB, para un proyecto paralelo que necesitaba inferencia privada y sin conexión.
El montaje
Pi 5, 8GB de RAM, refrigeración activa (el ventilador oficial, no una carcasa pasiva -- más abajo explico por qué), un NVMe de 64GB por el HAT PCIe en vez de tarjeta SD para que cargar el modelo no sea el cuello de botella. El runtime es llama.cpp, compilado con -DGGML_NATIVE=ON para que aproveche las instrucciones NEON del Cortex-A76, con modelos en formato GGUF cuantizados a Q4_K_M.
cmake -B build -DGGML_NATIVE=ON -DCMAKE_BUILD_TYPE=Release
cmake --build build --config Release -j4
./build/bin/llama-cli -m qwen2.5-0.5b-instruct-q4_k_m.gguf \
  -p "Resume esta línea de log: " -n 128 -t 4
Lo que es realista
Con modelos pequeños (0.5B-2.7B parámetros, Q4_K_M) sí se consigue una velocidad interactiva usable de verdad:
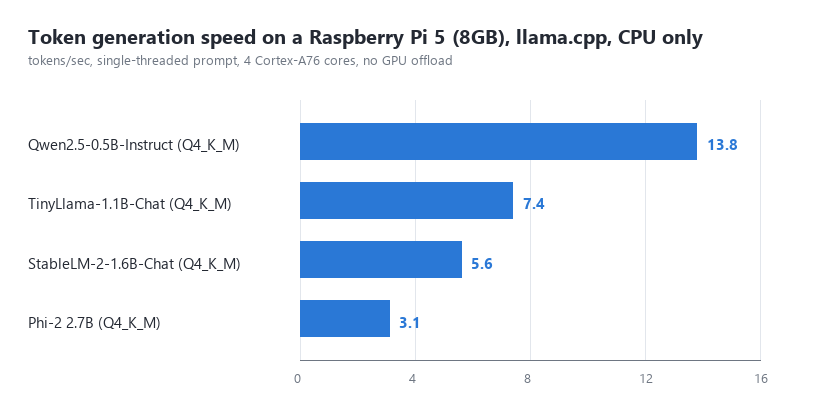
13-14 tok/s en un modelo de 0.5B es lo bastante rápido como para que la salida se sienta al ritmo de la lectura. Al llegar a 2.7B bajas a unos 3 tok/s, que ya es territorio de "verlo pensar" -- aceptable para un trabajo en segundo plano, tedioso para un chat.
También probamos, por curiosidad, un modelo de la clase 7B (Q4_K_M, unos 4.1GB en disco). Carga, pero el procesamiento del prompt antes del primer token tardó más de 40 segundos, y la generación cayó por debajo de 1 tok/s en cuanto el sistema operativo, el propio overhead de llama.cpp y la caché KV del modelo empezaron a competir por los mismos 8GB. Sirve para un trabajo por lotes que se deja corriendo de noche; no sirve para nada con una persona esperando delante.
La RAM es el verdadero límite
Presupuesto en una Pi 5 de 8GB: Raspberry Pi OS Lite con un par de servicios en segundo plano consume entre 400 y 600MB en reposo. Eso deja unos 7.3GB para todo lo demás. Un modelo Q4_K_M necesita el tamaño del archivo en disco más un 15-25% extra para la caché KV con una ventana de contexto modesta (probamos con 2048 tokens). Un modelo de 2.7B en Q4_K_M ocupa cerca de 1.6GB en disco y entra sin problemas dejando margen para otras cosas corriendo; si subes la ventana de contexto a 8192 tokens, la caché KV sola añade entre 500MB y 1GB más según el número de cabezas de atención del modelo, y ahí es donde empieza el swapping y todo se cae.
La realidad térmica
La inferencia sostenida es una carga de CPU sostenida, no algo intermitente como una petición web. Con una carcasa pasiva, vimos que el SoC llegaba a 82°C en unos 90 segundos y el kernel reducía la frecuencia, lo que tumbaba el rendimiento cerca de un 30% durante el resto de la ejecución. Con el disipador activo oficial, se estabilizó sobre los 68°C y mantuvo la frecuencia máxima. Si vas a hacer algo más que un prompt suelto, cuenta con refrigeración activa -- no es opcional en cuanto el chip se mantiene a tope durante varios minutos seguidos.
Cuándo vale la pena
- Tomar notas o resumir sin conexión, cuando el dispositivo de verdad no tiene red, o no quieres que los datos salgan del edificio.
- Clasificación o enrutado simple de intención (unos cientos de tokens de entrada, unos pocos de salida) donde 2-3 tok/s da igual porque la salida es una etiqueta, no prosa.
- Demos y kioscos donde el punto es precisamente "mira, esto corre entero en esta placa tan pequeña".
Cuándo no
Si la tarea necesita algo parecido al razonamiento de un modelo de la clase GPT-4, una ventana de contexto larga, o tienes que atender más de una petición a la vez, una API en la nube es más rápida y más barata en cualquier dimensión que importe. Una Pi 5 bajo carga de inferencia sostenida consume entre 8 y 10W; eso es dinero real a lo largo de un año, y a cambio obtienes una fracción de los tokens/seg que te da una llamada en la nube que cuesta fracciones de céntimo, sin tener que gestionar tú la térmica. La inferencia local en una Pi se gana su lugar cuando la privacidad o el funcionamiento sin conexión son un requisito real, no como medida para ahorrar costes.